分かち書きする言語しない言語のトークン化を統一的に扱う方法を妄想してみる
日本語で文を書くときには、分かち書き(文節や単語の間にスペースを入れる)をしないことが多い。 一方で英語などでは分かち書きをする。
ニューラルな言語処理の文脈で英語と日本語の語彙を共有して扱うとき1、この違いは地味に扱いにくい。
実は、分かち書きしない言語はマイナーで、日本語、タイ語、中国語くらいしかないらしいので、言語の割合的には統一的に扱う方法はあまり意味がないのかもしれないが、今回はそれを考えてみる。
分かち書きする言語しない言語のトークナイズを統一的に扱う方法
A. 分かち書きする言語しない言語の基本的なトークン化
分かち書きを行う言語 では、基本的にスペースをトークンの目印として使い、トークナイズする。
トークナイズした後はスペースはいったん消して、モデルの出力をスペースでつなぎ合わせて最終的な文を得る。
ただし、最近はスペースで分けたトークンをさらに細かく分割することで限られた語彙数の下で効率と精度の向上を狙うことも多い。
この場合、あるトークンが前のトークンにつながるトークンであることを表示する。
例
'But Tenjin are not relieved from Bonno (earthly desires).'
['but', 'ten', '##jin', 'are', 'not', 'relieved', 'from', 'bonn', '##o', '(', 'earthly', 'desires', ')', '.']
分かち書きをしない言語 では、ひとつながりの文字列を何らかのモデルで分割してトークナイズする。 スペース(を使う場合)は、そのまま残しておいて、モデルの出力を''でつなぎ合わせて最終的な文を得る。
例
'しかしながら煩悩から解き放たれては居ない。'
['しかしながら', '煩', '悩', 'から', '解', 'き', '放', 'た', 'れて', 'は', '居', 'ない', '。']
(それぞれの文は『Wikipedia日英京都関連文書対訳コーパス』より引用)
これらの特徴をまとめると次のようになると考えられる。
| 分かち書きする | 分かち書きしない | |
|---|---|---|
| トークン化したときのスペース | 消す | 残す |
| トークン化したときの連結 | 残す | 消す |
| 連結するときの文字列 | ' ' | '' |
2種類の扱い方は相補的になっている。
B. どちらにも対応できるようにするには
では、この2つのトークンの扱い方を統一するにはどうするのが良いだろうか?2
連結を表示する方法を採用すると、スペースを採用する言語の表記が長くなってしまうし、逆もまたしかりだ。
そこで、どちらかに限定するのではなく両方を扱える方針で考えてみる。
例を示すとこのような感じ('_'はスペースを'##'は連結を表す):
'But Tenjin are not relieved from Bonno (earthly desires).'
['but', '_', 'ten', '##', 'jin', '_', 'are', '_', 'not', '_', 'relieved', '_', 'from', '_', 'bonn', '##', 'o', '_', '(', '##', 'earthly', '_', 'desires', '##', ')', '##', '.']
'しかしながら煩悩から解き放たれては居ない。'
['しかしながら', '##', '煩', '##', '悩', '##', 'から', '##', '解', '##', 'き', '##', '放', '##', 'た', '##', 'れて', '##', 'は', '##', '居', '##', 'ない', '##', '。']
トークン列の'##'を見つけたらその両端のトークンをつなぎ合わせたうえで、''で連結すればどちらの立場のトークン化でも、もとの文が復元できる。
C. 制御文字を導入して冗長性を減らす
しかし、このままでは冗長でかなり文字列が長くなってしまう。
そこで、2つの立場を表す制御文字を先頭に導入する。
- <j=' '>: スペースを省略していて、スペースで連結する。
- <j=''>: 連結を省略していて、''で連結する。
['<j=' '>', 'but', 'ten', '##', 'jin', 'are', 'not', 'relieved', 'from', 'bonn', '##', 'o', '(', '##', 'earthly', 'desires', '##', ')', '##', '.']
['<j=''>', 'しかしながら', '煩', '悩', 'から', '解', 'き', '放', 'た', 'れて', 'は', '居', 'ない', '。']
D. 制御文字の選択
できるだけ文の長さは短いほうがよいので、いったん何の言語で書かれているかは忘れて、短くなる方を採用することを考えてみる。
言語によらず出現割合に基づいてトークナイズできるSentencePieceを用いてトークン化のモデルを作ったとする(ただし、スペースを強制的に1トークンとする)。
文をトークン化したとき、トークン数をn、スペースの数をsとすれば、自分の前がスペースではないトークン(つまり、連結しているトークン)の数cは次の式で表せる。
c = (スペースではないトークン数) - (スペースの数) = (n - s) - s
sとcを比較して、sが大きいときは連結を表示する方が系列長を短くでき、逆にsがc以下の時はスペースを表示した方が短くできる。
s > c ⇔ s/n > 1/3
従って、全トークンに対するスペースの占める割合が1/3を超えたときは、連結を表示し、1/3を下回ったときはスペースを表示する選択が効率的である。
実験と結果
では、現実に存在するコーパスに適用した場合どのようになるだろうか。
今回は、次の3つトークナイズのモデルを用意し、トークン列の長さの観点で比較を行った。
(スペース表示) スペースを1トークンとして強制したSentencePiece3 (語彙数: 日英の合計約40,000)
(space-switching) 2 + スペース/連結両者の表示 + 制御文字 + 制御文字の選択
『Wikipedia日英京都関連文書対訳コーパス』から日英44359文対をサンプルし、それぞれのモデルでトークナイズを行った。
結果は下表。
| スペースを表示 | space-switching | (WordPiece) | |
|---|---|---|---|
| 平均トークン化時間[マイクロ秒/文] | 87 | 92 | 433 |
| 英語平均トークン数[token/文] | 54.8 | 45.8 | 32.9 |
| 日本語平均トークン数[token/文] | 23.0 | 24.0 | 36.6 |
日本語では制御文字<join=''>を先頭に付加した分、1トークン増えている。
これは想定できる結果である。英語については平均トークン数が54.8から45.8に減少(83%)し系列長の削減に一定の効果があることがわかる。 しかし、bertに付属したWordPieceの平均長に対しては139%長く、期待したほど系列長は短くなってはいない。
英語のトークナイズを連結表示に変えても系列長があまり減少しない原因には次のようなものが考えられる。
- カンマやピリオド、引用符、かっこ等の記号が連結記号を伴ってしまい2倍の場所をとる。
- eが含まれる部分が分割されることが多く場所をとる。
トークナイズの結果を観察していると、we, be, -ed, -es, -erなど頻出する語、部分文字列が分割されている場合が多かった。 これは推測だが、英語ではeを含む部分文字列が多く、それらを個別にトークン化するよりもeを単体としてトークン化した方がカバレッジが上がると、sentencepieceは判断しているものと思われる。
1, 2で上げたようなトークンを特別に扱うルールを設ければ系列長はもう少し減少できそうだが、汎用性とのトレードオフになる。
この方法は汎用性と効率(系列長)が比較的バランスしているのではないだろうか。
Google ColabのTPUでtransformerを学習
注: この記事は2019年4月29日現在のColabとTensorflow(1.13)での話です。
概要
kerasで書かれたtransformerをtf.kerasで書き直してGoogle Colabの無料で使えるTPU上で学習させた。
デモとして「Wikipedia日英京都関連文書対訳コーパス」を使って英→日翻訳を学習。
(入力・出力それぞれ)1024トークンx8を1バッチとしたものを8TPUで処理できることを確認。
また、サンプル(50万対弱)を5周するのにかかった時間は6483秒だった。
使用したリポジトリ:
https://github.com/iki-taichi/tf-keras-transformer
ノートブック:
https://github.com/iki-taichi/tf-keras-transformer/blob/master/notebook/tf_keras_transformer.ipynb
(ColabでPython3を開いてTPUを有効にし、ノートブックを再現可能)
今回リポジトリの使い方と、実装の変更点のメモ。
リポジトリを使ってColab TPUで学習するステップ
Colabについて参考にさせていただいた記事
- Google ColaboratoryのTPUを試してみる - @koshian2 Qiita
- Google ColabのTPUで対GPUの最速に挑戦する - @koshian2 Qiita
- ColabのTPUでNASNet Largeを訓練しようとして失敗した話 - Shikoan's ML Blog
- TPUで学習率減衰させる方法 - Shikoan's ML Blog
1. Google Colaboratory にアクセスしPython3ノートブックを開く
Colabにブラウザでアクセスして新しいPython3ノートブックを開く。
2. ノートブックのアクセサレーターをTPUに変更
ランタイム → ランタイムのタイプを変更 → ハードウェアアクセサレータのプルダウンからTPUを選択 → 下部の保存を押す。
3. Google Driveをマウント(使う場合のみ)
from google.colab import drive
drive.mount('/content/drive')
以上をセルに入力すると、Google Drive File Streamを承認してねとurl付きのメッセージが表示されるので、urlを踏み、問題なければ表示されたページで承認する。 すると文字列が出力されるので、コピー。セルに戻ってテキストボックスに貼り付けてエンターを押す。
成功すると、以降ノートブックから"/content/drive/My Drive/"でGoogle Driveにアクセスできるようになる。
4. 外部プログラムのコピー
!pip install sentencepiece
!git clone --recursive https://github.com/iki-taichi/tf-keras-transformer.git
sentencepieceはデフォルトのトークナイザーのために使用。
tf-keras-transformerのgit clone時はtokenizerサブモジュールも同時にcloneするために、--recursiveオプションを付けるので注意。
5. リポジトリのディレクトリに移動
import os
os.chdir('tf-keras-transformer')
6. コーパスの用意
!python src/get_kyoto_corpus.py
「(Wikipedia日英京都関連文書対訳コーパス)https://alaginrc.nict.go.jp/WikiCorpus/index.html」をダウンロード後、 tf-keras-transformer/data内に検証用のkyoto_en_ja_valid.csvと学習用のkyoto_en_ja.csvを2:8の割合で出力する。 それぞれ、1行に1対の入力文、出力文をカンマ区切りで並べた標準的なcsvファイル。
7. 学習用の設定と実行
from src.fitting import FitEnvironment
env = FitEnvironment(
        use_tpu=True,
        batch_size=8,
        input_len=(1024, 1024),
        num_epoch=5,
        output_dir='/content/drive/My Drive/transformer_model',
        data_path=['data/kyoto_en_ja.csv'],
        valid_path=['data/kyoto_en_ja_valid.csv'],
        resume_model_path=None,
        resume_initial_epoch=None,
    )
env.run()
設定の意味:
- use_tpu: TPUを使い場合はTrue。
- batch_size: 1系列に複数のサンプルを詰め込むのであまり意味はない。はcolabのTPUはデバイス数に合わせて8。
- input_len: 入出力の最大トークン数を指定(TPUの場合は固定値が必要)。
- num_epoch: コーパスを周回する回数。ただし、毎回ランダムにサンプルを詰め込むので1エポックの総数は変動するので厳密にすべてのサンプルを同じ回数学習するわけではない。目安。
- output_path: モデルの保存先。今回はマウントしたGoogle Driveを指定。
- data_path: 学習データへのパスのリスト。
- valid_path: 検証データへのパスのリスト。エポックの終わりに毎回ロスとtoken-wiseの正解率を計算(Noneも可)。
- resume_model_path: 学習済みのモデルを追加で学習する場合に指定。
- resume_initial_epoch: 追加学習する場合の始まりのエポック番号を指定(そこからステップ数を算出して、学習率のスケジュールを決める)。
今回はデフォルトを使用しているが、モデルのパラメータを指定する場合はmodel_configを指定。
↓ デフォルトのmodel_config
from src.transformer import Config
model_config = Config(
        src_tokenizer='sp_uncase_en_ja_40000',
        tar_tokenizer='sp_uncase_en_ja_40000',
        use_same_embed=True,
        block_num=(6, 6),
        embed_dim=768,
        hidden_dim=3072,
        head_num=12,
        attention_activation='relu',
        feed_forward_activation='gelu',
        dropout_rate=0.10,
    )
8. 待つ
ログの前半
主にモデルのサマリーが出力される。
今回は、エンコーダー・デコーダーのembedding、デコーダーのpresoftmaxの3つを重み共有し、エンコーダー・デコーダーそれぞれにresidual blookを6個積んで、合計 129,997,888パラメータのモデル (すべて学習可能パラメータ)を学習。
次の図はTensorboardのグラフ出力。
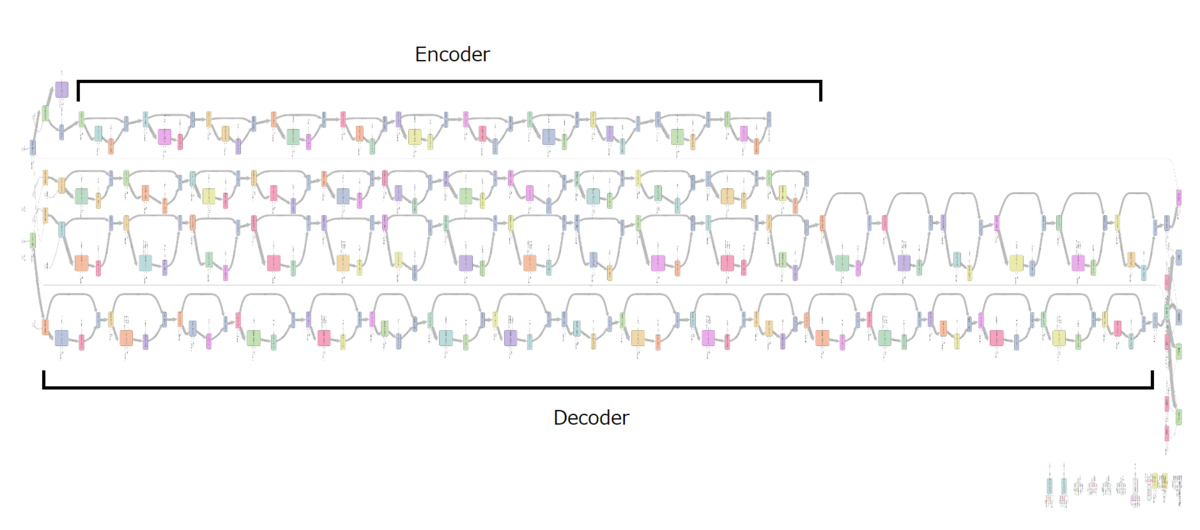
エンコーダーはSelf-Attention/Feedforwardで1単位だがデコーダーはSelf-Attention/Query-Key-Attention/Feedforwardで1単位なので長い。
それぞれが重複して2本出てくる理由は不明。
ログの後半
モデルのコンパイルが終わると学習が始まる。
WARNING:tensorflow:Method (on_train_batch_begin) is slow compared to the batch update (0.988424). Check your callbacks.
step_run=100 step_total=100 step_per_epoch=2909 loss=9.4850 masked_sparse_categorical_accuracy=0.0247 lr=7.0605e-06
step_run=200 step_total=200 step_per_epoch=2909 loss=7.9419 masked_sparse_categorical_accuracy=0.0880 lr=2.1324e-05
step_run=300 step_total=300 step_per_epoch=2909 loss=7.0836 masked_sparse_categorical_accuracy=0.1150 lr=3.5588e-05
...
ログ用のcallbackはcallbacks.TensorBoardとバッチごとに指標を監視するコールバック(NBatchLogger)を入れて、100エポックごとに更新。
はじめだけ、callbackが遅いという警告が出るが、問題はなさそう。
検証データを入れている場合は途中でモデルの再コンパイルが始まり、その後検証用の計算が起きる。 再コンパイルは1回目だけ起きる。
INFO:tensorflow:Finished compiling. Time elapsed: 67.5693416595459 secs
296/296 [==============================] - 147s 498ms/step - loss: 3.8432 - masked_sparse_categorical_accuracy: 0.3716
step_run=3000 step_total=3000 step_per_epoch=2909 loss=3.7968 masked_sparse_categorical_accuracy=0.3626 lr=4.2071e-04
step_run=3100 step_total=3100 step_per_epoch=2909 loss=3.7822 masked_sparse_categorical_accuracy=0.3728 lr=4.3497e-04
...
TensorBoardのグラフ

検証データのステップ表記がずれていたので学習データに合わせて伸縮。 もう少し学習・検証ともにロスが下がりそう(5エボックでは短かったと思われる)。
学習に要した時間
合計 6483 s
内訳
- Fitを始めるまでの準備: 119 s
- TPUモデルのコンパイル(mode=train): 151 s
- TPUモデルのコンパイル(mode=eval): 68 s
- その他イテレーションの計算: 6145 s (1229 s/epoch)
学習後に出力されるファイル
- .hdf5のモデルファイル(5エポックごと + 全部完了後)
- kerasのhistory callbackの出力(json)
- tensorboard用のログ(events.out.tfevents.*)
90分を超える場合はリセット対策
Google Colaboratory の 90分ルールを回避したい。 - @Gimina_Graph Qiita
9. 学習済みモデルで推論する
tf.keras.backend.clear_session()
from src.transformer import TransformerWrapper
trans = TransformerWrapper('/content/drive/My Drive/transformer_model/model.05.hdf5')
trans('Kyoto is a Japanese city.')
# '京都(きょうと)は、日本の市。'
変な挙動はしてなさそう。
感想
ネットにつながるだけで誰でもTPUで計算できる。
8並列が強い。メモリー容量上GPU1台と乗せられるモデルの大きさはあまり変わらないが、8並列なので(GPUと等速だとしても)最大8倍高速に学習できる。
ただし、モデルの転送やコンパイルに時間がかかるのでデータ量が少量の場合は逆に時間がかかる。
以降、細かい部分。
ベースとして利用したtransformerの実装
CyberZHGさんがMITライセンスで公開しているkeras-transformerをベースとして利用。
フレームワークはkeras。
pypiで公開されているが、今回はtensorflow用に書き換える必要があったためpip installではなく、依存するファイルを洗い出してコピーしてきて改変。
主な変更が必要だったこと
tf.kerasで書かれたモデルはtf.contrib.tpu.keras_to_tpu_modelでTPUで動くモデルに変換できる。 これを利用してモデルを変換するため、また、効率的にモデルに入力が流せるようにするためにいくつかの変更を施した。
- kerasをtf.kerasに変更
- バッチサイズ以外の次元が確実に数値で入るようにする
- Embedding層のweight出力前に適当な演算を挟む
- マスク付きのロスを自前で実装する
- 固定シーケンス長でも同時に複数サンプルを学習できるようにPos-IdsとGroup-Idsを導入
kerasをtf.kerasに変更
これは、書いてある通り。
keras-transformerの各ファイルの上部に"import tensorflow as tf"を追加し、機械的にkerasをtf.kerasに置換した。
kerasのモデルのままでkeras_to_tpu_modelすると例外がおきる。
バッチサイズ以外の次元が確実に数値で入るようにする
tf.kerasに変更したら、そのまま動くことを期待したが、そうもいかなかった。
0次元(batchsize)以外のテンソルの次元がNoneではダメと怒られるので、まず入力シーケンス長を固定値にする。
また、入力シーケンス長を固定値にしても、途中でreshapeを挟むと次元が決まっているのにプレースホルダーになってしまう箇所がある。そうならないよう数値を指定するように変更(multi_head_attention.pyのここなど)。
Embedding層のweight出力前に適当な演算を挟む
今回のtransformerでは、入力と出力の重みを共有するためにEmbedding層が(普通の埋め込みベクトル、そのもととなるレイヤーの重み全体)の2つを出力するように実装されている。
そして、もととなるレイヤーの重み(variable)をそのまま出力してしまうと、「ReplicatedVariableはkerasのレイヤー出力ではない」というエラーが出てしまう。
色々試した結果、ダミーの演算(tf.cast(weights, tf.float32)など)をレイヤーを出す前に挟んでやることでこのエラーが回避できることが分かった(ここ)。
学習は進んでいるので大丈夫だと思うが、ひょっとしたら、何か副作用があるかもしれない。
マスク付きのロスを自前で実装する
上の3つでとりあえず動作するようになるが、Embeddingのzero_maskをTrueにしてpaddingされている部分のマスクを指定しても、現状のTPUモデルではなぜかlossの計算にマスクが反映されない。
そこで、マスクを有効にするため、標準のsample_weights, maskは使わずに、自前のマスク付きのロスを用意した(masked_softmax_cross_entropy_with_logit)。
なお、このロスは入力側からくるマスクではなく、chainerのように教師データ側の-1ラベルをマスク対象とするように作成した。
固定シーケンス長でも同時に複数サンプルを学習できるようにPos-IdsとGroup-Idsを導入
上の4つで学習までできるようになるが、シーケンス列を固定長にして長い固定長を設定した場合にパディングばっかりになってしまうため、効率が悪い。
そこで、入力にPos-IdsとGroup-Idsを付け足し、1つの系列に複数のサンプルを詰め込むように改造した。
Token-Ids: トークンの識別番号(これまでの入力)
Group-Ids: ひとつの系列に含まれる同一サンプルのトークンに同じ番号を割り当てる。Self-Attention, Query-Key-Attentionをするときに同じ番号のトークンを条件としてマスクをあてることで、他のサンプルの情報を見ないようにする。
Pos-Ids: トークンがサンプル内の何番目かを入力する。
デモとしてダウンロードするコーパスの情報
https://alaginrc.nict.go.jp/WikiCorpus/index.htmlで配布されているWikipedia日英京都関連文書対訳コーパスを使用する(使用時はライセンスを確認のこと)。
国立研究開発法人情報通信研究機構が作成したコーパス。京都に関係あるwikipedia日本語版の記事を人手で翻訳したコーパス(45万文対くらいあったと思います)。
日本語で無料で手に入るデータセットとしては質・量ともにレベルが高いと思われる(ただし、用語と言葉遣いに多少の偏りがある)。
テキストのトークナイズ
SentecePiece。
英語wikipedia, 日本語wikipediaから持ってきた600,000記事(2言語の記事が大体バランスするようにサンプル)の本文で学習したSentecePieceをトークナイザーとして使用。合計で40,000トークン。
トークナイザーは別リポジトリとして作成し、submoduleとして参照。
このトークナイザーでは、スペースを強制的に1トークンにする設定にしたが、英語をトークナイズするときスペースが系列長を無駄に占めてしまうのが若干課題。
(英語の入力長が日本語に比べてかなり長くなってしまう傾向があるため、出力側に無駄が多い)
google/bertリポジトリのFullTokenizerと同一のインターフェースのため、必要であれば取り換え可能。
全体の参考
Attention Is All You Need
Transformerの提案論文Training Tips for the Transformer Model
学習の条件等が詳しく書いてある(去年の4月の記事)
Sentencepieceの水増しをBERTで試してみる
前回、事前学習済みのbertモデルbert-japaneseを使って対話破綻検知チャレンジ(Dialog Breakdown Detection Challenge)コーパスでのファインチューニングを行った。
結果は決して悪いものではなかったが、当時(DBDC2)のトップモデルの性能には届かなかった。
bert-japaneseは文字列のトークン化にsentencepieceを採用しているので、sentencepieceのSampleEncodeAsPiecesを用いたデータの水増しが可能である。
今回は、dbdcのファインチューニングでトークン化に関する水増しを試してみる。
参考
変更点
モデル、コーパス、学習条件は前回のDBDCの学習と同一。
トークン化の際に水増しを行うため、学習スクリプトに以下の変更を施した。 (変更後の学習スクリプトrun_dbdc_classifier.py)
tokenizerのtokenizeでEncodeAsPieces, SampleEncodeAsPiecesを使い分け
SentencePieceTokenizerにenabled_samplingというboolの変数を持たせ、この真偽で2つのエンコード方法を使い分ける。
このようにして学習時はSampleし、他の時はベストのトークン化を行う。
SampleEncodeAsPiecesのn_best_sizeは-1, alpha=0.1を用いる。なお、この値はいくつかの文をサンプルにかけて適度に揺らぐことを確認ている。
トークン化前後でenabled_samplingを変更
bertのスクリプトで事例のトークン化が行われているのは、convert_single_example関数内である。
さらに、file_based_convert_examples_to_featuresで各事例に対してこの関数が呼び出される。
学習時にfile_based_convert_examples_to_featuresが実行される直前に
- examplesをエポックの数だけコピー
- Tokenizerのenabled_samplingをTrueに変更
とすることでトークン化をサンプリングモードに変え、トークン化を揺らがし、file_based_convert_examples_to_featuresが実行された後で普通のトークン化に戻す。
一応この部分のコードは下記:
  if FLAGS.do_train:
    train_file = os.path.join(FLAGS.output_dir, "train.tf_record")

    # Augmentation on tokenization
    train_examples *= int(FLAGS.num_train_epochs)
    tokenizer.enabled_sampling = True
    file_based_convert_examples_to_features(
        train_examples, label_list, FLAGS.max_seq_length, tokenizer, train_file)
    tokenizer.enabled_sampling = False

    tf.logging.info("***** Running training *****")
    # ... コードが続く ...
この方法だと、tfrecordにサンプル数 x エポック数のデータを書き込むため多少ディスク容量を食うが、dbdcのデータは1エポック分が3.5MB程度だったので問題はないと思われる。
トークン化の水増しをして学習した結果
ロスの曲線

学習曲線にはそれほど差がみられない。
評価結果
前回同様参考としてDBDC2のNTTCSrun2の結果を引用した(DBDC2)。
BERT水増しなし-10は前回の記事の結果。
今回は、水増しありで10エポックと、水増しあり/なしで20エポックの学習を行った。
ばらつきの参考として、水増しあり20エポックは2回学習し、その両方の結果を示した。
| NTTCS run2 | BERT 水増しなし -10 | BERT 水増しあり -10 | BERT 水増しなし -20 | BERT 水増しあり -20(1) | BERT 水増しあり -20(2) | |
|---|---|---|---|---|---|---|
| エポック数 | - | 10 | 10 | 20 | 20 | 20 |
| (loss-valid) | - | 0.201 | 0.197 | 0.207 | 0.199 | 0.202 |
| (Acc.-valid) | - | 0.591 | 0.611 | 0.579 | 0.585 | 0.598 |
| Acc.-DCM | 0.565 | 0.523 | 0.507 | 0.529 | 0.545 | 0.544 |
| Acc.-DIT | 0.655 | 0.62 | 0.618 | 0.62 | 0.655 | 0.627 |
| Acc.-IRS | 0.584 | 0.595 | 0.611 | 0.593 | 0.607 | 0.607 |
| JS-Div. (O,T,X)-DCM | 0.085 | 0.083 | 0.0829 | 0.0841 | 0.0783 | 0.0815 |
| JS-Div. (O,T,X)-DIT | 0.046 | 0.043 | 0.0418 | 0.0455 | 0.0428 | 0.0445 |
| JS-Div. (O,T,X)-IRS | 0.101 | 0.091 | 0.0899 | 0.0922 | 0.0867 | 0.09 |
(Acc.は破綻3ラベルの正解率、JS-Div.は3ラベル分布のJSダイバージェンス、DCM, DIT, IRSは対話システムの種類を表す)
水増しあり20の2回の結果には、DITのAccuracyと分布距離系統評価値にばらつきがみられる。
水増しあり10エポックは水増しなし10エポックよりもラベル系統指標における劣化が見られるが、20エポックまで学習すると水増しなしの方はほとんど変化がないのに対して水増しありの方は、平均的には精度が向上している。
十分に学習させれば、トークン化に関する水増しには一定の効果があると見える。
ただし、どのBERTの結果を見てもまだラベル系統はNTTCSrun2の精度には追いつけていないが。
感想
トークン化時の水増しの効果は確かにありそうだ。
Sentencepieceの使用時はトークン化の水増しを試してみる価値はあるのではないだろうか(そのときは、水増しをしていない時より学習に時間がかかるようになるため、少し長めに学習エポックを設定するとよい)。
BERTで対話破綻検知
対話破綻検知チャレンジは人と対話システムとの雑談対話に対して○、△、×の3値分類を行うコンペティションで今まで3回行われている。
データが公開刺されいるので、今回はこのタスクについてBERTをファインチューニングしてみる。
対話破綻検知チャレンジ(Dialog Breakdown Detection Challenge; DBDC)のタスクとBERTへの入力
DBDCでの破綻検知タスク
- 対話システムの最終発話、そこに至るまでの人と対話システムの対話履歴がそれぞれ文字列として与えられ、最終発話に関して、破綻(×)、おそらく破綻(△)、破綻ではない(○)を判定する。
- 対話履歴は最大で20ターンある。
- データセットには人手で判定がアノテーションされている。
- DBDC ~ DBDC3まで少しずつデータが増やされている。今回はDBDC, DBDC2のデータを用いる。
- DBDCのdev, eval対話データとDBDC2のdevの対話データを学習に用いた(ただしそのうちの25%は検証データセット)。DBDC2の評価セットでDCM, DIT, IRSそれぞれの対話システムごとテストを行う。
- DBDCデータが合計100対話(各21ターン)、DBDC2-devデータが合計150対話(各21ターン)で、学習に用いるのは(100+150)*0.75=188対話。
BERTへの入力
BERTへの最終発話と対話履歴の与え方は自明ではない。
今回は、BertのIsNext学習となるべく類似するようにと考え、以下の方針でいくこととした。
- BERTでは各ターンの発話を再帰的に入力することはできないので、一度の入力で最終発話を対話履歴をすべて入力するものとする。
- "[CLS]<ターン1発話>スペース<ターン2発話>....[SEP]<判定対象発話>[SEP]"をトークン数制限(512)まで詰め込む。
- SegmentIDは前半の文脈発話では0、判定対象発話では1とする。
- [CLS]の次に3次元に変換する線形変換をかませて3値分類する。
_truncate_seq_pair 関数の改変
run_classifier.pyで512より長いトークン系列を切り捨てる際には、tokena, tokenbで長いほうの後ろからトークンを捨てて行って収まるようにしてある。今回、文脈発話の後ろが捨てられると重要な部分が抜ける恐れがあるため、前方から捨てるように変更を加えた。
KLダイバージェンスの最適化
DBDCでは評価尺度としてラベル系統と分布距離系統の2つが採用されている。
今回は、分布距離系統を重視するためsoftmax_cross_entorpyの計算時に(正解ラベルではなく)ラベル分布を与えることでlossを計算する(soft target)。
といっても、tf.nn.softmax_cross_entropy_with_logits_v2のlabels引数に分布を与えるだけなので。難しいことはない。
ハットがついているpはモデルの出力、ハットのないpは教師データの確率分布、iがデータを走り、jがクラスを走る。
tf.nn.softmax_cross_entropy_with_logits_v2が計算するのは前半のsum。
後半のsumは勾配に関与しないが分布が一致したときにlossが0になるためにつけている。これは結局のところpとのKLDだ。
関連部分のコードを抜き出すと次のようになる。
    # 学習済みモデルの出力(output_weights)をクラス分類の出力に線形変換
    logits = tf.matmul(output_layer, output_weights, transpose_b=True)
    logits = tf.nn.bias_add(logits, output_bias)

    # 後の判定処理のためにロジットを確率に変換
    probabilities = tf.nn.softmax(logits, axis=-1)

    # ロジットと正解分布(labels)からロスを計算
    per_example_loss = tf.nn.softmax_cross_entropy_with_logits_v2(labels, logits, axis=-1)
    per_example_loss += tf.reduce_sum(tf.log(tf.pow(labels, labels)), axis=-1)
    loss = tf.reduce_mean(per_example_loss)
データの準備と学習
- "dbdc_corpus.py -m fetch"を実行(データをダウンロードしてtsvに加工)。
- run_dbdc_classifier.pyを実行
run_dbdc_classifier.pyの引数は下記
python src/run_dbdc_classifier.py \
    --task_name=DBDC \
    --do_train=true \
    --do_eval=true \
    --data_dir=data/dbdc \
    --model_file=model/wiki-ja-mod.model \
    --vocab_file=model/wiki-ja-mod.vocab \
    --init_checkpoint=model/model.ckpt-1400000 \
    --max_seq_length=512 \
    --train_batch_size=4 \
    --learning_rate=2e-5 \
    --num_train_epochs=10 \
    --output_dir=model/dbdc_1
(model/wiki-ja-mod.model(.vocav)は後処理付きのsentencepieceだが、model/wiki-ja.model(.vocab)とほぼ同一)
スクリプトは以下のリポジトリに保存
https://github.com/iki-taichi/bert-japanese
主な関連スクリプト:
- src/dbdc_corpus.py
- src/run_dbdc_classifier.py
結果
同一条件で3回学習した結果、検証データに関して以下のようにラベル精度が得られた。
| dbdc_1 | dbdc_2 | dbdc_3 | |
|---|---|---|---|
| 3クラス分類精度 | 0.5881 | 0.5793 | 0.5910 |
dbdc_3の学習曲線:

検証データに関して、最も高い精度だったdbdc_3をテストセットで評価し、DBDC2のNTTCSrun2, HCUrun3と比較した。
DBDC2のサイトより引用したNTTCSrun2は3つの対話システムに関して一貫して高い性能を示し、学習したデータもほぼ同一であるため比較対象とした。 また同じところから引用したHCUrun3はRNNをベースにした深層モデルのアンサンブルであり、同じ深層モデルの目安として参照した。
各指標で最も良い値を太字にする。 なお、ラベル系統(-label)は数値が高いほどよく、分布距離系統(-distribution)はすうちが小さいほど元の分布に近く良い。
DCM-label
| pretrained bert | NTTCSrun2 | HCUrun3 | |
|---|---|---|---|
| Accuracy | 0.523 | 0.565 | 0.504 |
| Precision (X) | 0.556 (69/124) | 0.523 | 0.520 |
| Recall(X) | 0.388 (69/178) | 0.584 | 0.292 |
| F-measure (X) | 0.457 | 0.552 | 0.374 |
| Precision (T+X) | 0.837 (267/319) | 0.875 | 0.910 |
| Recall(T+X) | 0.744 (267/359) | 0.624 | 0.396 |
| F-measure (T+X) | 0.788 | 0.728 | 0.551 |
DCM-distribution
| pretrained bert | NTTCSrun2 | HCUrun3 | |
|---|---|---|---|
| JS divergence (O,T,X) | 0.083 | 0.085 | 0.100 |
| JS divergence (O,T+X) | 0.053 | 0.057 | 0.072 |
| JS divergence (O+T,X) | 0.052 | 0.054 | 0.061 |
| Mean squared error (O,T,X) | 0.046 | 0.044 | 0.055 |
| Mean squared error (O,T+X) | 0.055 | 0.056 | 0.074 |
| Mean squared error (O+T,X) | 0.055 | 0.054 | 0.067 |
DIT-label
| pretrained bert | NTTCSrun2 | HCUrun3 | |
|---|---|---|---|
| Accuracy | 0.62 | 0.655 | 0.624 |
| Precision(X) | 0.695 (216/311) | 0.632 | 0.655 |
| Recall(X) | 0.818 (216/264) | 0.943 | 0.818 |
| F-measure(X) | 0.751 | 0.757 | 0.727 |
| Precision(T+X) | 0.895 (374/418) | 0.900 | 0.904 |
| Recall(T+X) | 0.908 (374/412) | 0.891 | 0.842 |
| F-measure(T+X) | 0.901 | 0.910 | 0.872 |
DIT-distribution
| pretrained bert | NTTCSrun2 | HCUrun3 | |
|---|---|---|---|
| JS divergence (O,T,X) | 0.043 | 0.046 | 0.052 |
| JS divergence (O,T+X) | 0.025 | 0.030 | 0.033 |
| JS divergence (O+T,X) | 0.027 | 0.030 | 0.035 |
| Mean squared error (O,T,X) | 0.024 | 0.025 | 0.029 |
| Mean squared error (O,T+X) | 0.025 | 0.029 | 0.032 |
| Mean squared error (O+T,X) | 0.031 | 0.034 | 0.041 |
IRS-label
| pretrained bert | NTTCSrun2 | HCUrun3 | |
|---|---|---|---|
| Accuracy | 0.595 | 0.584 | 0.505 |
| Precision(X) | 0.635 (169/266) | 0.554 | 0.534 |
| Recall(X) | 0.732 (169/231) | 0.801 | 0.580 |
| F-measure(X) | 0.680 | 0.655 | 0.556 |
| Precision(T+X) | 0.793 (302/381) | 0.791 | 0.757 |
| Recall(T+X) | 0.846 (302/357) | 0.773 | 0.602 |
| F-measure(T+X) | 0.818 | 0.782 | 0.671 |
IRS-distribution
| pretrained bert | NTTCSrun2 | HCUrun3 | |
|---|---|---|---|
| JS divergence (O,T,X) | 0.091 | 0.101 | 0.118 |
| JS divergence (O,T+X) | 0.059 | 0.068 | 0.081 |
| JS divergence (O+T,X) | 0.059 | 0.070 | 0.082 |
| Mean squared error (O,T,X) | 0.050 | 0.054 | 0.066 |
| Mean squared error (O,T+X) | 0.061 | 0.065 | 0.080 |
| Mean squared error (O+T,X) | 0.062 | 0.074 | 0.091 |
感想
分布距離系統ではbertとNTTCSrun2の性能は互角か、bertのほうが若干良い傾向がでている。しかし、ラベル系統ではNTTCSrun2がDCM, DITのAccuracyで上回っている。
Bertのラベル系統の性能はHCUrun3より良いが劇的に変化しているわけではない。
分布距離系統が良いのはsoft targetの影響もあると考えられる(つまり、bertじゃなくてもsoft targetで分布距離を学習させたら改善する可能性がある)。
総合すると、対話のデータではないWikipediaの事前学習と対話のデータ(DBDC-dev, DBDC-eval, DBDC2-dev)だけでもそこそこの性能が出るが、分析に基づいた分類器を超すことはできなかったと言えそう。
もう少し対話に近いデータで事前学習する、マルチターン(あるいは3文以上)を考慮した構造にすることで、もう少し改善するかもしれない。
新辞林
ノイズが少ない日本語語義リストを探していた。
もちろんwikipediaでも良いのだが、もう少し基本的な語彙を含んでいるものがいい。
そこでCD-ROM付き辞典がいいのではと思い付いた。例えば、以下は良さそうだ。
このうちハイブリッド新辞林は出品者が信頼できそうだったので購入。
とりあえずはじめに、付録CD-ROMの指示通りにソフトをインストールしてみると、、、
20年以上前の製品でwindows95用と書いてあったので期待してなかったが、何の問題もなく見れた。

なんだか感動。
そして、本題。
DTONIC Toolkitで形式の変更を試みる。

右下の「パス1」を押して1分くらい待つと、無事"dtout.txt"というファイルが出力された。
これは辞書の内容がSGML形式に変換されたファイルらしい。
これでも読めなくなさそうだが、さらに「パス2」を押して待つ。今度はSGMLからHTMLへの変換だ。
図のファイルなどとともに"dtout.html"が出力された。
中には定義タグが大量に書かれている。表記の参考としていくつか引用する。
(新辞林 あ【唖】、あ【亜】)
<dt id="0100000300">あ【唖】</dt>
<dd>


話しことばが重度に障害され,ことばをまったく,あるいは,ほとんど発することができない状態。


<dt id="0100000400">あ【亜】</dt>
<dd>


[1]

(接頭)

<br>
  (1)…に次ぐ。

「―熱帯」

<br>
  (2)中心原子の酸化数が,基準となるものより小さいことを表す。

「―硫酸」

<br>
[2]

アジア(亜細亜)。

「東―」
いい感じだ。
sentencepiece APIの詳細を調べる (bert-japanese関連)
bert-japaneseのモデルを使っているとsentencepieceへの入力と出力が異なる場合がしばしばあって、文字数のずれが気になったのでsentencepieceについてもう少し調べた。
sentencepieceのNormalizerは何をしてる
sentencepieceのテキストのノーマライズ処理はunicodedata関係とその他の処理がbuilder.ccとnormalizer.ccに記述。
sentencepiece_model.proto内のNormalizerSpecでノーマライズ処理の指定が定義されている。
| 名称 | 説明 |
|---|---|
| name | 名前 |
| precompiled_charsmap | ユーザ定義以外の変換規則 |
| add_dummy_prefix | 先頭に追加でスペースをつけるか(デフォルト=True) |
| escape_whitespaces | スペースをu2581にエスケープするか(デフォルト=True) |
| remove_extra_whitespace | 先頭、文中、末尾のスペースを1つに集約するか(デフォルト=True) |
| normalization_rule_tsv | ユーザ定義以外の変換規則 |
また、NormalizeSpecとは別にtreat_whitespace_as_suffix_というフラグもある。
これらの指定はモデルの学習前に決めておく必要あり。
unicodedata関係
デフォルトのnmtNFKCはunicodedataに基づいたNFKCのマッピングを基本とし、一部変更を加えてprecompiled_charsmapに保持。 (NFKCとは大雑把に、「は+゜」⇔「ぱ」のように修飾文字と被修飾文字を分けて書くこともできる部分を、分けないでコード化する正規化の方式)
具体的な変更は以下の規則の追加と削除。
(https://github.com/google/sentencepiece/blob/master/src/builder.cc)
util::Status Builder::BuildNmtNFKCMap(CharsMap *chars_map) {
#ifdef ENABLE_NFKC_COMPILE
  LOG(INFO) << "Running BuildNmtNFKCMap";

  CharsMap nfkc_map;
  RETURN_IF_ERROR(Builder::BuildNFKCMap(&nfkc_map));

  // Other code points considered as whitespace.
  nfkc_map[{0x0009}] = {0x20};  // TAB
  nfkc_map[{0x000A}] = {0x20};  // LINE FEED
  nfkc_map[{0x000C}] = {0x20};  // FORM FEED
  nfkc_map[{0x000D}] = {0x20};  // CARRIAGE RETURN
  nfkc_map[{0x1680}] = {0x20};  // OGHAM SPACE MARK
  nfkc_map[{0x200B}] = {0x20};  // ZERO WIDTH SPACE
  nfkc_map[{0x200E}] = {0x20};  // LEFT-TO-RIGHT MARK
  nfkc_map[{0x200F}] = {0x20};  // RIGHT-TO-LEFT MARK
  nfkc_map[{0x2028}] = {0x20};  // LINE SEPARATOR
  nfkc_map[{0x2029}] = {0x20};  // PARAGRAPH SEPARATOR
  nfkc_map[{0x2581}] = {0x20};  // LOWER ONE EIGHT BLOCK
  nfkc_map[{0xFEFF}] = {0x20};  // ZERO WIDTH NO-BREAK
  nfkc_map[{0xFFFD}] = {0x20};  // REPLACEMENT CHARACTER
  nfkc_map[{0x200C}] = {0x20};  // ZERO WIDTH NON-JOINER
  nfkc_map[{0x200D}] = {0x20};  // ZERO WIDTH JOINER

  // Ascii Control characters
  nfkc_map[{0x0001}] = {};
  nfkc_map[{0x0002}] = {};
  nfkc_map[{0x0003}] = {};
  nfkc_map[{0x0004}] = {};
  nfkc_map[{0x0005}] = {};
  nfkc_map[{0x0006}] = {};
  nfkc_map[{0x0007}] = {};
  nfkc_map[{0x0008}] = {};
  nfkc_map[{0x000B}] = {};
  nfkc_map[{0x000E}] = {};
  nfkc_map[{0x000F}] = {};
  nfkc_map[{0x0010}] = {};
  nfkc_map[{0x0011}] = {};
  nfkc_map[{0x0012}] = {};
  nfkc_map[{0x0013}] = {};
  nfkc_map[{0x0014}] = {};
  nfkc_map[{0x0015}] = {};
  nfkc_map[{0x0016}] = {};
  nfkc_map[{0x0017}] = {};
  nfkc_map[{0x0018}] = {};
  nfkc_map[{0x0019}] = {};
  nfkc_map[{0x001A}] = {};
  nfkc_map[{0x001B}] = {};
  nfkc_map[{0x001C}] = {};
  nfkc_map[{0x001D}] = {};
  nfkc_map[{0x001E}] = {};
  nfkc_map[{0x001F}] = {};

  //  <control-007F>..<control-009F>
  nfkc_map[{0x007F}] = {};
  nfkc_map[{0x008F}] = {};
  nfkc_map[{0x009F}] = {};

  // Do not normalize FULL_WIDTH TILDE, since FULL_WIDTH TILDE
  // and HALF_WIDTH TILDE are used differently in Japanese.
  nfkc_map.erase({0xFF5E});

  RETURN_IF_ERROR(RemoveRedundantMap(&nfkc_map));

  *chars_map = std::move(nfkc_map);

#else
  LOG(ERROR) << "NFKC compile is not enabled."
             << " rebuild with ./configure --enable-nfkc-compile";
#endif

  return util::OkStatus();
}
主にスペースの半角スペースへの集約と制御文字の除去が定義されているが、突然日本語のローカルルールが出てきていて趣き深い。
その他の処理
NormalizeSpecのフィールドのprecompiled_charsmap以外の部分とtreat_whitespace_as_suffix_で挙動が決まる。
treat_whitespace_as_suffix_
これがTrueの時は「word1_, word2_, word3_」のように単語の後ろにスペースが付くようにノーマライズされる。逆にFalseだと先頭につく。デフォルトはFalse。
add_dummy_prefix
「word1 word2 word3」を「word1, _word2, _word3」とノーマライズすると先頭の単語だけスペースが付かない状態になる。 先頭に_をつけてやることですべての単語を先頭にスペースを付けて扱えるようにするためにadd_dummy_prefixをつける(treat_whitespace_as_suffix_=Trueの時は最後にスペースが付くように書かれている)。
日本語はスペースで区切る言語ではないのでadd_dummy_prefix=Trueにすると逆に文頭のトークンだけスペースがついてしまう。だから、日本語の場合はadd_dummy_prefix=Falseで良いと思われる。
処理まとめ
ここまでの話をまとめると、完全に同一にできているかテストはしていないが、pythonでnmtNormalizeを模倣すると次のような感じになりそう。
import unicodedata

nmt_norm_map = str.maketrans({
        # Other code points considered as whitespace.
        '\u0009':'\u0020',  # TAB
        '\u000A':'\u0020',  # LINE FEED
        '\u000C':'\u0020',  # FORM FEED
        '\u000D':'\u0020',  # CARRIAGE RETURN
        '\u1680':'\u0020',  # OGHAM SPACE MARK
        '\u200B':'\u0020',  # ZERO WIDTH SPACE
        '\u200E':'\u0020',  # LEFT-TO-RIGHT MARK
        '\u200F':'\u0020',  # RIGHT-TO-LEFT MARK
        '\u2028':'\u0020',  # LINE SEPARATOR
        '\u2029':'\u0020',  # PARAGRAPH SEPARATOR
        '\u2581':'\u0020',  # LOWER ONE EIGHT BLOCK
        '\uFEFF':'\u0020',  # ZERO WIDTH NO-BREAK
        '\uFFFD':'\u0020',  # REPLACEMENT CHARACTER
        '\u200C':'\u0020',  # ZERO WIDTH NON-JOINER
        '\u200D':'\u0020',  # ZERO WIDTH JOINER

        # Ascii Control characters
        '\u0001':'',
        '\u0002':'',
        '\u0003':'',
        '\u0004':'',
        '\u0005':'',
        '\u0006':'',
        '\u0007':'',
        '\u0008':'',
        '\u000B':'',
        '\u000E':'',
        '\u000F':'',
        '\u0010':'',
        '\u0011':'',
        '\u0012':'',
        '\u0013':'',
        '\u0014':'',
        '\u0015':'',
        '\u0016':'',
        '\u0017':'',
        '\u0018':'',
        '\u0019':'',
        '\u001A':'',
        '\u001B':'',
        '\u001C':'',
        '\u001D':'',
        '\u001E':'',
        '\u001F':'',

        #  <control-007F>..<control-009F>
        '\u007F':'',
        '\u008F':'',
        '\u009F':'',
    })

def normalize_with_nmt_NFKC(
        text,
        treat_whitespace_as_suffix_=False,
        add_dummy_prefix=True,
        remove_extra_whitespaces=True,
        escape_whitespaces=True,
    ):

    # custom mapping for nmt
    text = text.translate(SentencePieceTokenizer.nmt_norm_map)
    # tilde protection (storing)
    tildes = filter(lambda c: c == '\uFF5E' or c == '\u007E', text)
    # nfkc normalization
    text = unicodedata.normalize('NFKC', text)
    # tilde protection (restoring)
    text = ''.join([c if c != '\u007E' else next(tildes) for c in text])

    # triming extra spaces
    if remove_extra_whitespaces:
        text = re.sub('\u0020+', '\u0020', text.strip())
    # dummy space
    if add_dummy_prefix:
        if treat_whitespace_as_suffix_:
            text = text + '\u0020'
        else:
            text = '\u0020' + text
    # escaping spaces
    if escape_whitespaces:
        text = text.replace('\u0020', '\u2581')

    return text
これを施したテキストにアノテーションすれば文字数のずれは起きないはず。
[蛇足] bert-japaneseの学習済みsentencepieceの分割への後処理
sentencepieceのNormalizerが何をしているか分かったところでbert-japaneseに戻す。
デフォルトで学習しているようなのでadd_dummy_prefix=Trueだ。 前回見たように、一部の語彙が先頭にスペースが付いた状態で登録されていて、スペースをとった部分が語彙に含まれていなかったことの要因はこの設定の影響もあると考えられる。
先頭にスペースがないと使えなくなってしまう語彙があるのは微妙なので何とかしたい。しかし、学習済みモデルの語彙に大幅な変更は加えないほうがいい。
そこで、トークン化の後処理で全ての先頭のスペースを別トークンとして分離してみる。
- スペースを分離した結果、対応するトークンがなくなってしまう175語彙は、もともとスペースが先頭にあった語彙の.vocabの表層からスペースを消してスペースがなかったことにする。
- ついでに、「、」で始まるトークンにも同様の処理を行う。
.vocabの書き換え: replace_sp_vocab.py
後処理をするtokenizer: tokenization_sp_mod.py
実験
- 書き換えた.vocabと後処理を行うtokenizerでLivedoorニュースコーパスの分類タスクを再び転移学習。
- 他の条件は前回の転移学習と同一。
結果
全ての学習データ4421記事のうち、今回の変更で影響を受けたトークンがあった記事は4224記事。変えたところが使われなかったということはない。アルファベットのトークンから先頭のスペースが分離されたパターンが多かった。
| 用いた学習データの割合 | 前回のF値 | 今回のF値 |
|---|---|---|
| 100% | 0.965 | 0.965 |
| 5% | 0.857 | 0.847 |
→ 書き換える前と比べて変化はなし。
感想
bert-japaneseの学習済みsentencepieceモデルを眺める
bert-japaneseでは日本語のテキストのトークン化にsentencepieceが使われる。
日本語版wikipedia(リポジトリのconfig.iniによると20181220のダンプ)で学習されたsentencepieceのモデルが作者のサイトのgoogle driveで公開されている。
今回はこのsentencepieceモデルをながめてみる。sentencepieceをあまりちゃんと使ったことがないので、使い方も含めて見ておく。
モデルに関連するファイル
モデルに関連するファイルはwiki-ja.model, wiki-ja.vocabの2つだ。
wiki-ja.model
sentencepieceの学習済みモデルのそのもので、これをライブラリに読み込ませてテキストを分割する。
wiki-ja.vocab
sentencepieceの分割処理自体には不要だが、分割された文字列をBERTに与える時にidに変換するための辞書の役割を果たしている。wiki-ja.vocabは1行ごとに文字列とスコアがタブ区切りで記された単純なファイルだ。
Sentencepieceを使っている部分
sentencepieceを呼び出してトークン化するクラスは次のように書かれていた。
bert-japaneseのtokenization_sentencepiece.pyから
class SentencePieceTokenizer(object):
    """Runs SentencePiece tokenization (from raw text to tokens list)"""

    def __init__(self, model_file=None, do_lower_case=True):
        """Constructs a SentencePieceTokenizer."""
        self.tokenizer = sp.SentencePieceProcessor()
        if self.tokenizer.Load(model_file):
            print("Loaded a trained SentencePiece model.")
        else:
            print("You have to give a path of trained SentencePiece model.")
            sys.exit(1)
        self.do_lower_case = do_lower_case

    def tokenize(self, text):
        """Tokenizes a piece of text."""
        text = convert_to_unicode(text)
        if self.do_lower_case:
            text = text.lower()
        output_tokens = self.tokenizer.EncodeAsPieces(text)
        return output_tokens
loadで学習済みモデルを読み込んでおき、EncodeAsPiecesを日本語文字列を引数として呼び出すと、分割された文字列がリストとして返却されるようだ。
Sentencepieceのリポジトリを見ると、文字列を分割する関数は何種類かある。
| 関数 | 機能 |
|---|---|
| EncodeAsPieces(text) | textを最もスコアが高い方法で分割してリストを返却 |
| NBestEncodeAsPieces(text, nbest_size) | textの分割のうちスコアがnbest_size番目までを返却 |
| SampleEncodeAsPieces(text, nbest_size, alpha) | nbest_size, alphaを満たすtextの分割からランダムに1つを返却 |
それぞれ次のような動きをする:
from pprint import pprint
import sentencepiece as sp
tokenizer = sp.SentencePieceProcessor()
tokenizer.load('model/wiki-ja.model')
# True
text = 'Sentencepieceって何?'

tokenizer.EncodeAsPieces(text)
# ['▁', 'S', 'ent', 'ence', 'pie', 'ce', 'って', '何', '?']

pprint(tokenizer.NBestEncodeAsPieces(text, 5))
# [['▁', 'S', 'ent', 'ence', 'pie', 'ce', 'って', '何', '?'],
#  ['▁', 'S', 'ent', 'ence', 'pie', 'c', 'e', 'って', '何', '?'],
#  ['▁', 'S', 'ent', 'ence', 'p', 'ie', 'ce', 'って', '何', '?'],
#  ['▁', 'S', 'ent', 'ence', 'pi', 'e', 'ce', 'って', '何', '?'],
#  ['▁', 'S', 'en', 't', 'ence', 'pie', 'ce', 'って', '何', '?']]

# 同一条件で5回サンプルしてみる
pprint([tokenizer.SampleEncodeAsPieces(text, -1, 0.1) for _ in range(5)])
# [['▁', 'S', 'ent', 'en', 'ce', 'p', 'ie', 'c', 'e', 'って', '何', '?'],
#  ['▁', 'S', 'ent', 'en', 'ce', 'p', 'ie', 'c', 'e', 'って', '何', '?'],
#  ['▁', 'S', 'ent', 'ence', 'pi', 'e', 'c', 'e', 'っ', 'て', '何', '?'],
#  ['▁', 'S', 'ent', 'en', 'ce', 'p', 'ie', 'ce', 'っ', 'て', '何', '?'],
#  ['▁', 'S', 'e', 'nt', 'e', 'nc', 'ep', 'ie', 'ce', 'って', '何', '?']]
SampleEncodeAsPiecesはちょっと変わった関数だが、そもそもSentencepieceには、(統計的に出現しやすい)色々な分割を出せれば、画像学習の時のようなデータの水増しが可能となるのでは?という発想が背景にあるらしく、それを実現するために存在している。
なお、出力にしばしば出ている「▁」(LOWER ONE EIGHTH BLOCK, '\u2581')はsentencepieceでスペースのかわりに使われる文字で、適宜スペースに置換する必要がある。先頭に必ず「▁」が付くのは仕様らしい。
2019-04-10変更: add_dummy_prefixフラグをTrueにすると、先頭に「▁」が付く。
(先頭の「▁」は独立でつくこともあるし、「▁aaa」が語彙にあれば非独立に出てくることもある)
モデルの語彙
Sentencepieceに少し慣れたところで、wiki-jaモデルの語彙を見る。作業内容はjupyter notebookの通り(途中の出力が長いので注意)。
まず、これは.vocabを見なくても分ることだが、語彙数は32000。
そのうち、アルファベットだけで出来ている語彙が1490あり、日本語版でもアルファベットがそこそこ含まれていることがわかる。
ソートして眺めていると、sentencepieceは「を続けている」、「が必要」、「契約を」、「存在しなかった」など、形態素的には複合した分割も学習している。
そこで、語彙の先頭が機能語等で始まっているものと逆に語尾が機能語等で終わっているものを集計してみる。
| 語彙の表層 | 始 | 終 |
|---|---|---|
| が | 429 | 155 |
| に | 817 | 470 |
| の | 688 | 659 |
| を | 1360 | 105 |
| と | 437 | 126 |
| とは | 14 | 4 |
| こと | 114 | 46 |
| として | 56 | 46 |
| は | 124 | 374 |
| も | 121 | 100 |
| から | 28 | 66 |
| で | 147 | 291 |
| する | 73 | 293 |
| し | 115 | 488 |
| され | 44 | 171 |
| という | 41 | 16 |
| て | 59 | 441 |
| まで | 12 | 34 |
| へ | 41 | 3 |
| る | 36 | 1369 |
| ら | 37 | 111 |
「を」で終わる語彙より始まる語彙のほうが多い、「が」は始まりにつく場合が多いが「は」は終わりにつく場合が多い、「の」は両方同程度ついているなど語ごとの偏りがみられる。 様々な機能語について複合語彙が学習されていて、形態素との関係を対応付けるのは容易ではなさそうだ。
この他気になったのは、「▁」や「、」で始まる語彙が少なからず出てくる点。
「▁」で始まる語彙は781、「、」を含む語彙は106あった。
「、」を含む語彙は「)、「」など括弧の間に「、」が入っているものと「、1990」のような西暦の前に「、」が入っているものだけだった。
一方、「▁」を先頭に持つ語彙は「▁」の後に普通の日本語や英単語がくっついているものが多かった。さらに「▁」を取り除いた部分が語彙に含まれない語彙が175あった。これには「よって」、「こうして」、「なぜなら」のような文の役割の手掛かりとなりうる語彙がふくまれていた。
感想
実はこの調査の目的には、先頭につく'▁'を機械的に取り除いてしまっても問題ないかを確かめることがあった(入力と文字数が変わってしまうと文字の位置が重要なタスク(SQuADなど)に影響する)。
先頭につく'▁'を機械的に取り除いてしまうと、175の語彙は漏れてしまうことが分かった。
32000中の175なのでそこまで影響はないだろうが、もったいない気もする。
